Modelos de decisión de IA: qué son y cómo usarlos
INTELIGENCIA ARTIFICIAL, BLOG.AUTOMATIZACIÓN.
En resumen: Los modelos de decisión de IA responden preguntas acotadas eligiendo entre opciones predefinidas y devuelven una probabilidad en la que el software puede basarse para actuar. Sus ventajas son la velocidad y el costo. En pruebas independientes, Jev, el modelo de decisión de TypeSafe AI, respondió con una mediana de 148 ms y un costo de USD 0,11 por cada 1.000 solicitudes. Un large language model (LLM) de propósito general, medido en batches en una sola GPU, registró 3.609 ms y USD 1,18. Desde el lanzamiento de Jev, el 15 de septiembre, la categoría se convirtió en un mercado competitivo. Cuando ya existen datos etiquetados, pequeños clasificadores entrenados pueden igualarlos o superarlos, y la redacción de cada pregunta cambia las respuestas. Un modelo de decisión es una etapa en el ciclo de vida de una decisión, junto a las reglas, los clasificadores entrenados y los LLMs.
Esta guía está dirigida a las organizaciones cuyo software enruta solicitudes, clasifica documentos o marca casos para revisión humana. Aborda la velocidad y el costo de los modelos de decisión de IA y los casos en que un clasificador entrenado sigue siendo la mejor opción. También explica cómo una decisión recurrente puede pasar de un enfoque a otro a medida que madura. Una aclaración de terminología: en gestión de procesos, "modelo de decisión" ya designa un modelo en Decision Model and Notation (DMN), que expresa la lógica de decisión en tablas que una persona puede leer regla por regla. En esta guía, "modelo de decisión" se refiere al de IA, y la última sección explica cómo se relacionan.
Qué es un modelo de decisión de IA y qué no es
Un modelo de decisión de IA es un modelo diseñado para hacer un tipo concreto de evaluación dentro del software. Recibe los datos de un caso y una o varias preguntas cuyas respuestas posibles se definen de antemano. Para cada pregunta devuelve un valor tipado: una probabilidad para cada opción, una posición en una escala o la probabilidad de un sí. No genera texto ni explica su razonamiento. Lo que entrega es una respuesta que el software puede almacenar, comparar con un umbral y usar para actuar, en lugar de un texto que haya que interpretar. Por eso los modelos de decisión se adaptan a las evaluaciones acotadas y repetitivas que los procesos de negocio hacen en grandes volúmenes, como enrutar una solicitud, clasificar un documento o determinar si un caso necesita revisión humana.
TypeSafe AI, que lanzó Jev el 15 de septiembre de 2026, los llama modelos System One. El nombre viene de Daniel Kahneman, premio Nobel de Economía, quien llamó Sistema 1 (System 1) al pensamiento rápido y automático, y Sistema 2 (System 2) al pensamiento lento, que exige esfuerzo. Lo expuso en Pensar rápido, pensar despacio, su libro de 2011 sobre cómo piensan y deciden las personas.
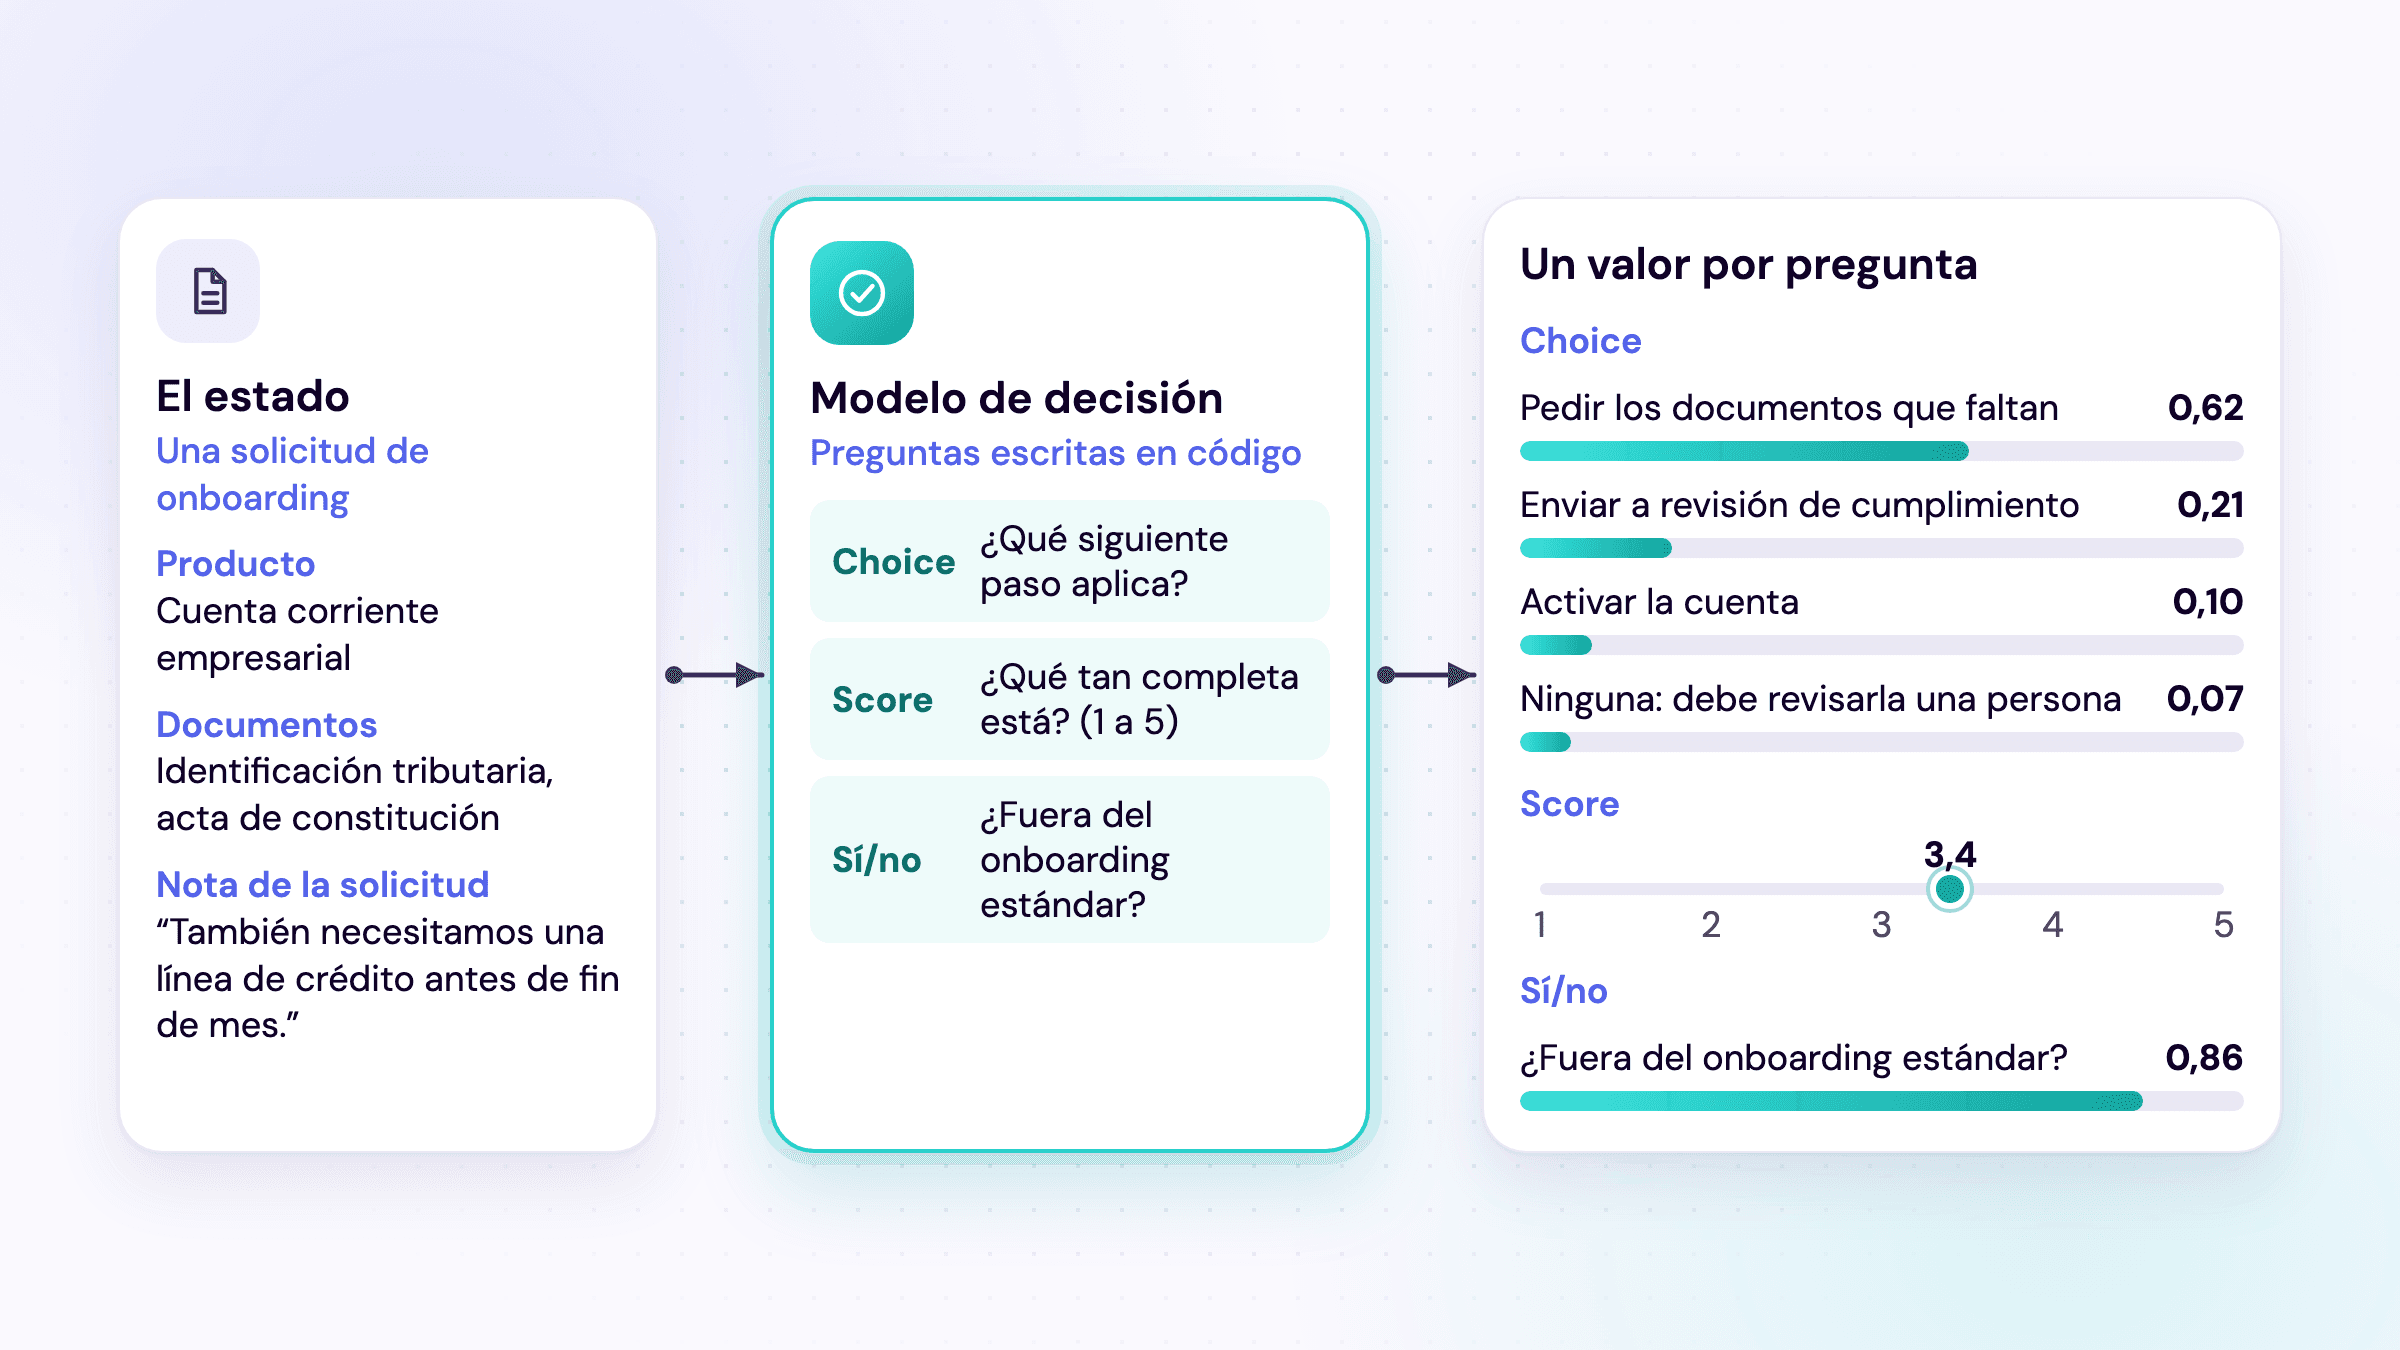
Considere, por ejemplo, una solicitud en un proceso de onboarding de clientes. El software le envía al modelo preguntas tipadas definidas en código y un estado: los datos del caso, en este ejemplo el producto solicitado, los documentos recibidos y la nota que acompaña la solicitud. El modelo devuelve un valor por pregunta.
Los modelos de decisión admiten estos tipos de pregunta:
Choice: elige una de hasta 255 opciones predefinidas y asigna una probabilidad a cada una. Cada opción tiene un nombre y, de forma opcional, una descripción en lenguaje natural.
Score: ubica el caso en una escala de 2 a 10 niveles, descritos en la pregunta.
Sí/no: devuelve una sola probabilidad. La pregunta puede describir qué significan el sí y el no. La API de Jev llama a este tipo "noul".
La probabilidad está diseñada para estar calibrada: los resultados a los que se asigna una probabilidad de 0,2 deberían ocurrir cerca del 20% de las veces. TypeSafe lo presenta como una propiedad del conjunto de muchas respuestas, no como una promesa sobre cada respuesta individual, y su documentación no publica ninguna cifra medida.
El término System One describe lo que devuelve un modelo, no cómo está construido, y desde entonces otros proveedores han lanzado sus propios modelos de decisión. Strands Decider 2B, de AWS, es un modelo de lenguaje de 2.000 millones de parámetros cuya salida de texto se reemplaza por una capa final que califica cada opción. Laya, de Convai Innovations, construye su checkpoint en inglés (una versión entrenada del modelo) sobre ModernBERT, un modelo mucho más pequeño, de 421 millones de parámetros.
La consultora HatchWorks distingue entre una respuesta válida, una respuesta correcta y una acción autorizada, que se confunden con facilidad. Por diseño, un modelo de decisión solo puede devolver una de las opciones que recibió, así que sus respuestas son válidas. Una evaluación con los datos de la propia organización muestra si son correctas, y las políticas y las personas de la organización deciden si el sistema puede actuar con base en ellas.
Un modelo de decisión también se diferencia de un clasificador entrenado. Un clasificador entrenado aprende sus categorías de las etiquetas de una sola tarea, es decir, de casos anteriores marcados con la respuesta correcta, y hay que reentrenarlo cuando esas categorías cambian. Un modelo de decisión, en cambio, recibe sus opciones en lenguaje natural con cada solicitud y puede responder varias preguntas en una sola llamada.
Modelo de decisión vs. LLM: velocidad, costo y salida
Los modelos de decisión tienen una ventaja clara en velocidad y costo. Un equipo de investigación de Texas State University comparó Jev con un LLM de propósito general en pruebas independientes, publicadas como preprint y todavía sin revisión por pares. La comparación se hizo en clasificación de intenciones, una tarea que ordena las solicitudes según lo que quiere quien las envía. Cuando la respuesta del LLM se leyó a partir de la probabilidad que asignaba a cada opción, el LLM igualó la exactitud (accuracy) de Jev: 0,912 frente a 0,913. Sin embargo, tardó considerablemente más y costó más por solicitud. La tabla compara un modelo de decisión con un LLM:
Modelo de decisión de IA | Large language model | |
|---|---|---|
Qué puede responder | Solo las preguntas y opciones definidas de antemano | Preguntas abiertas, planes y texto |
Qué devuelve | Un valor tipado por pregunta, entre las opciones definidas | Texto que la aplicación debe parsear, incluso en modo JSON, que restringe el formato pero sigue devolviendo texto |
Confianza | Una probabilidad por opción, diseñada para estar calibrada en el conjunto de las respuestas | La declara en su respuesta si se le pide, o se obtiene de la probabilidad que asigna a cada opción |
Explicación | Ninguna: no devuelve texto y no hay una regla que citar | En palabras |
Velocidad en una prueba | Mediana de 148 ms, Jev a través de su API | Mediana de 3.609 ms, un modelo de 27.000 millones de parámetros medido en batches en una GPU A100 |
Costo en una prueba | USD 0,11 por 1.000 solicitudes, al precio de lista de Jev | USD 1,18 por 1.000 solicitudes, con una tarifa por hora supuesta para esa GPU |
Cifras de velocidad y costo tomadas de esas pruebas. Las cifras del LLM se prorratean por batch: el tiempo y el costo de cada batch se reparten entre sus solicitudes. Cada columna se midió de forma distinta, así que las cifras no deben dividirse entre sí para obtener una proporción.
TypeSafe anuncia que Jev es 193,6 veces más rápido y 444,6 veces más económico que los LLMs en sus propios workflows. No identifica los modelos con los que comparó, ejecuta los LLMs a través de su propio wrapper y prevé que estas cifras se ubiquen en el extremo superior de las mejoras que se obtienen en la práctica. Kai Waehner, especialista independiente en arquitectura empresarial, espera un ahorro de costos de alrededor de un orden de magnitud en un sistema completo.
Qué modelos de decisión de IA están disponibles y cómo acceder a ellos
La tabla reúne los modelos de decisión lanzados hasta comienzos de octubre; cada uno enlaza a la página de su proveedor:
Modelo | Proveedor | Lanzamiento | Acceso | Qué lo distingue |
|---|---|---|---|---|
TypeSafe AI | 15 de septiembre | Early access, API alojada | USD 0,042 por millón de tokens de entrada, salida gratuita; 70–500 ms medidos por TypeSafe desde la costa oeste de Estados Unidos | |
Jared Palmer, quien dirigió el área de IA de Vercel | Pesos (weights) con licencia Apache 2.0, de 800 millones a 27.000 millones de parámetros | Acepta el formato de solicitud de Jev | ||
Convai Innovations | 18 de septiembre, creación del repositorio | Pesos con licencia Apache 2.0; se aloja en infraestructura propia | Checkpoints en inglés y multilingües; de 33 a 40 ms por pregunta en una GPU Tesla T4; diseñado para ajustarse a cada tarea con fine-tuning | |
OpenAI | 29 de septiembre | Preview limitada | Funciona con el modelo Luna de OpenAI; acepta texto o imágenes como contexto; sin documentación ni precios públicos en sus primeros días | |
AWS Strands Labs | 1 de octubre | Descargable, con datos y scripts de entrenamiento | Mediana de unos 115 ms en una GPU RTX 3090 | |
Cloudflare | 1 de octubre | Pesos con licencia Apache 2.0; alojados en Workers AI, de Cloudflare | Admite imágenes y el formato de solicitud de Jev |
Un directorio de la comunidad reúne más de una docena. Todas las cifras son las que publica cada proveedor.
Kai Waehner señala que varias plataformas añadieron acceso a Jev antes del 25 de septiembre. Sin embargo, la disponibilidad no muestra si las respuestas de un modelo son correctas para un proceso de negocio concreto.
Qué determina los resultados en la práctica: datos etiquetados, calibración, diseño de las preguntas y costo
Según las mismas pruebas independientes, estos factores determinan qué tan bien funciona un modelo de decisión en un entorno empresarial. Las pruebas evaluaron modelos de decisión como Jev, Laya y Kev, aunque no todos los modelos de la tabla anterior formaron parte de ellas. Las cifras se refieren principalmente a Jev:
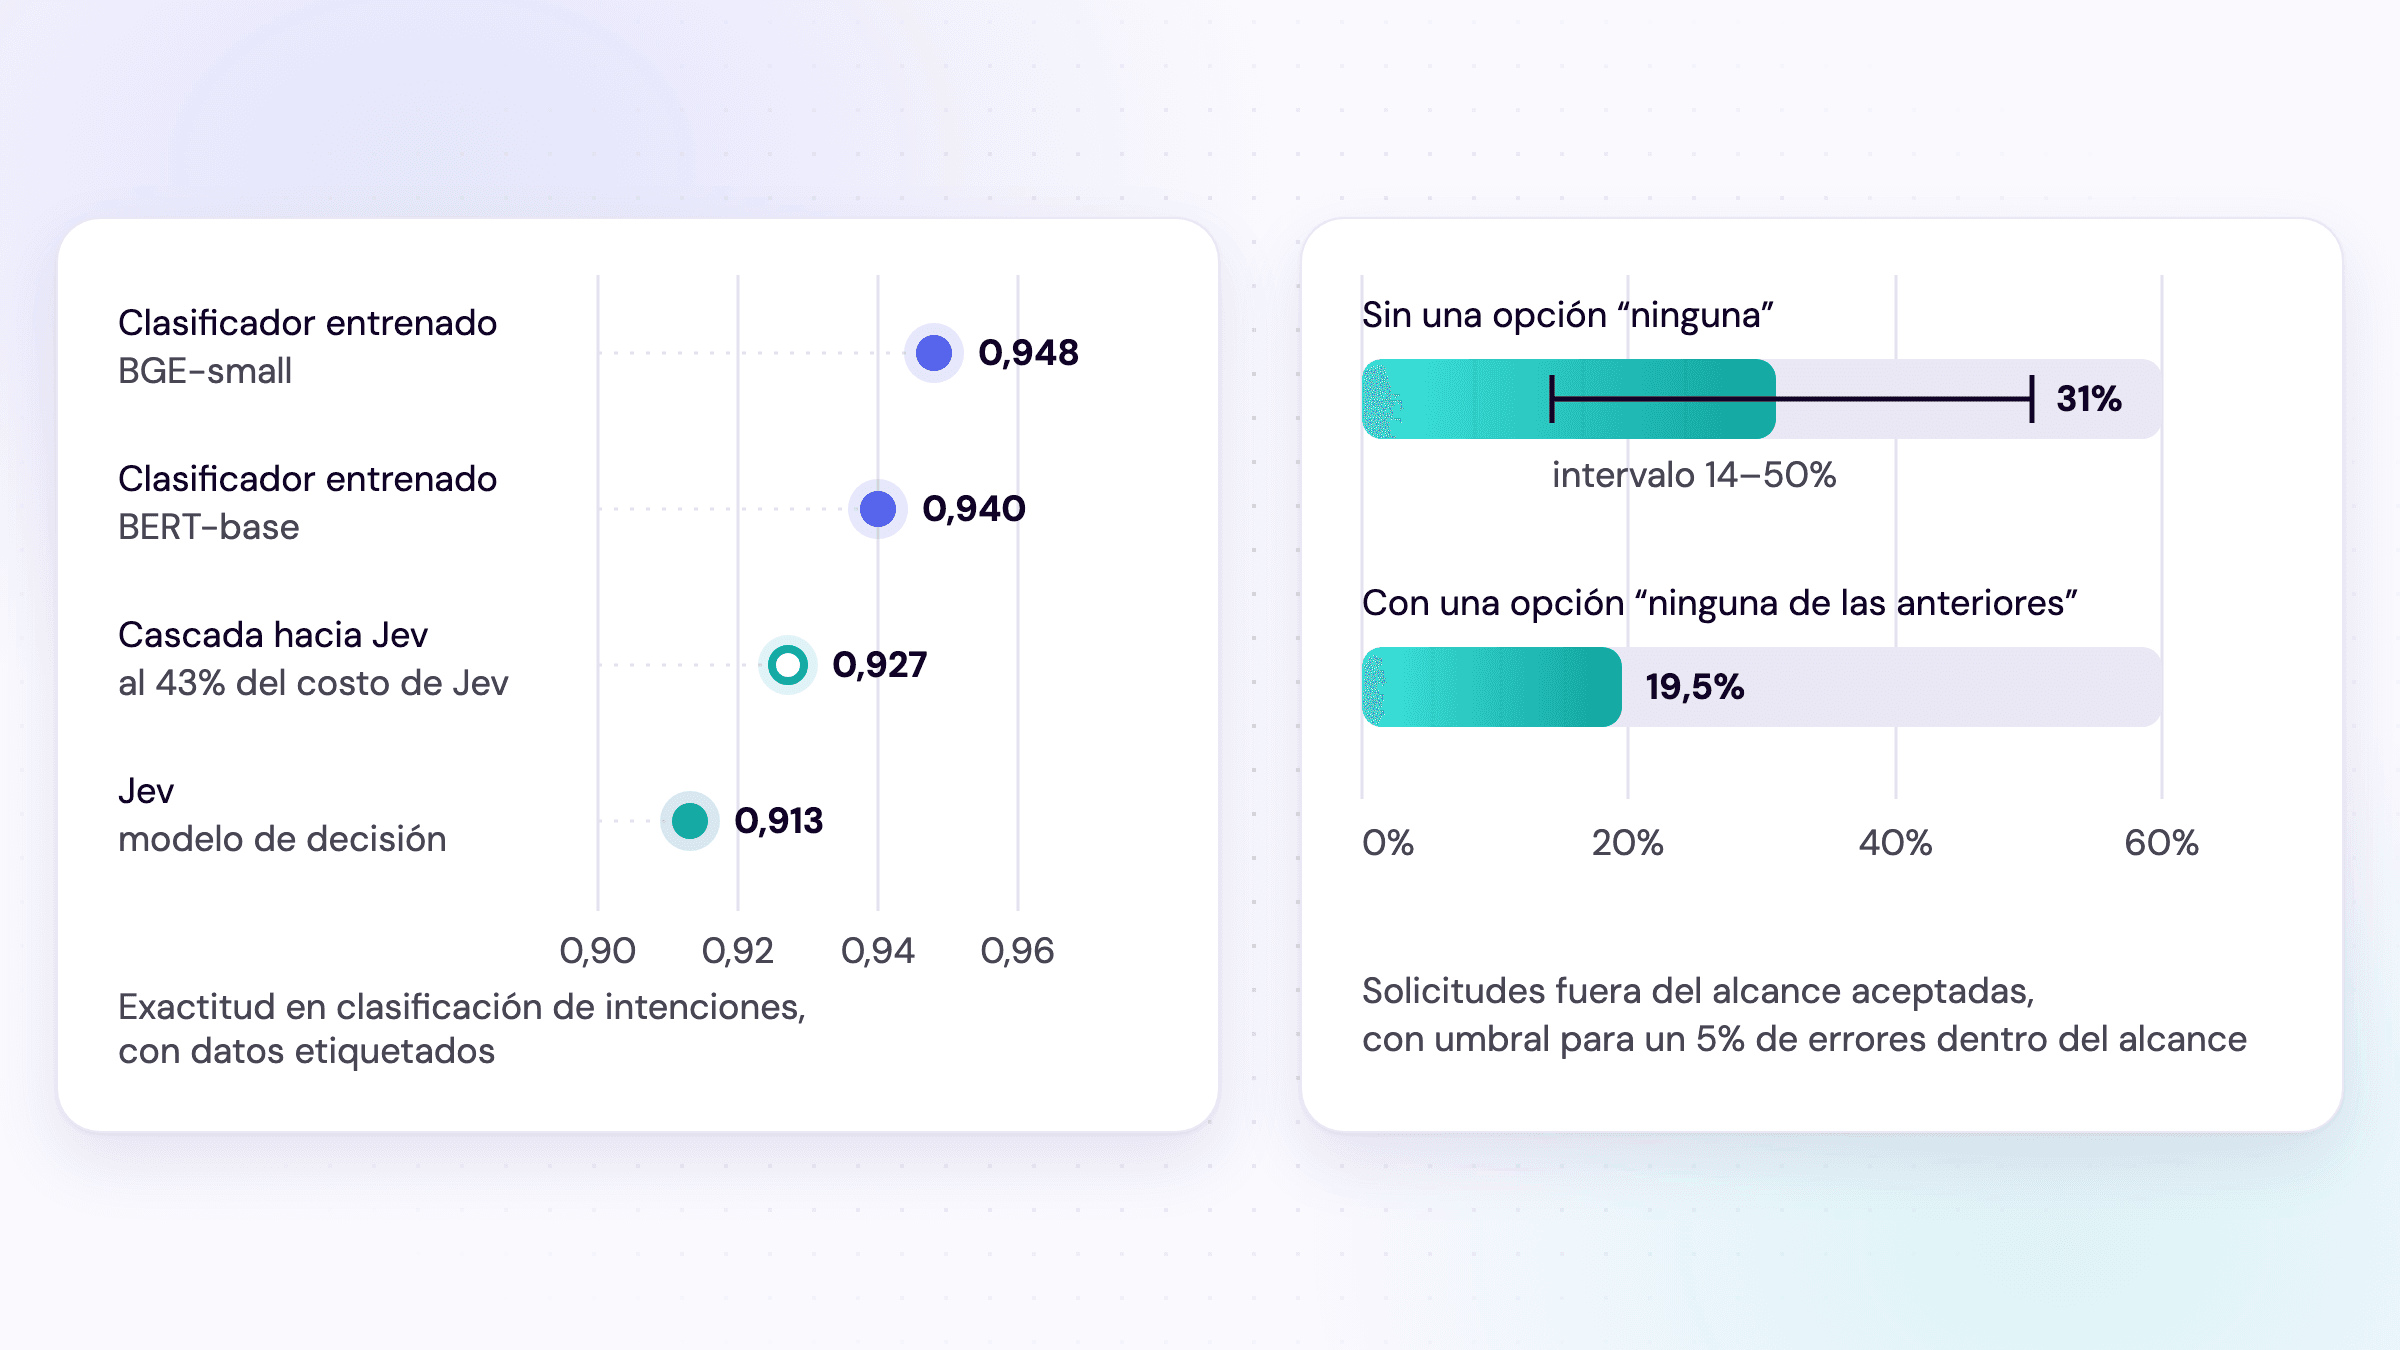
Historial etiquetado. Cuando una tarea ya tiene historial etiquetado, pequeños clasificadores entrenados pueden ser más exactos: 0,948 y 0,940 en clasificación de intenciones, frente a 0,913 de Jev. En decisiones de workflows de negocio, la diferencia no fue significativa.
Calibración. Las probabilidades que resultaron confiables en una tarea no lo fueron en otra, así que cada tarea necesita sus propios umbrales.
Diseño de las preguntas. El software solo actúa según una respuesta cuando su probabilidad supera un umbral. Las solicitudes fuera del alcance son las que no encajan en ninguna de las opciones. El umbral se fijó para un 5% de errores en las solicitudes dentro del alcance, y aun así Jev aceptó el 31% de las solicitudes fuera del alcance: asignó cada una a una opción con una probabilidad superior al umbral. El rango de incertidumbre reportado para esa cifra va de 14% a 50%. Añadir una opción explícita "ninguna de las anteriores" redujo ese 31% a 19,5%. En preguntas de workflows de negocio, se intercambiaron los nombres de las opciones sí y no para que cada uno contradijera su descripción escrita, y cerca de la mitad de las respuestas cambió.
Estructura de costos. Una cascada puede reducir el costo: un modelo de decisión pequeño, con fine-tuning sobre los datos etiquetados de la tarea (no un clasificador), le pasó a Jev solo los casos en que tenía dudas. La cascada igualó la exactitud de Jev con el 43% del costo de usar solo Jev. Este resultado se limita a la clasificación de intenciones y supone GPUs usadas a plena capacidad.
Dónde encajan los modelos de decisión de IA: una etapa en el ciclo de vida de una decisión
Las reglas, los clasificadores entrenados, los modelos de decisión y los LLMs pueden tomar decisiones en el software, cada uno con sus propias limitaciones:
Enfoque | Más adecuado cuando | Limitaciones |
|---|---|---|
Reglas y tablas de decisión DMN | La lógica se puede poner por escrito y debe explicarse regla por regla | No pueden evaluar texto libre |
Clasificador entrenado | La decisión es estable, de alto volumen y tiene historial etiquetado | Requiere etiquetas, y reentrenamiento cuando cambian las categorías |
Modelo de decisión | Las opciones o sus definiciones cambian a menudo y todavía no hay etiquetas para entrenar | No hay una regla que citar; la calibración varía según la tarea |
Large language model | La salida es lenguaje, un plan o una explicación | Más lento y más costoso por decisión |
Resumen de la comparación de Kai Waehner.
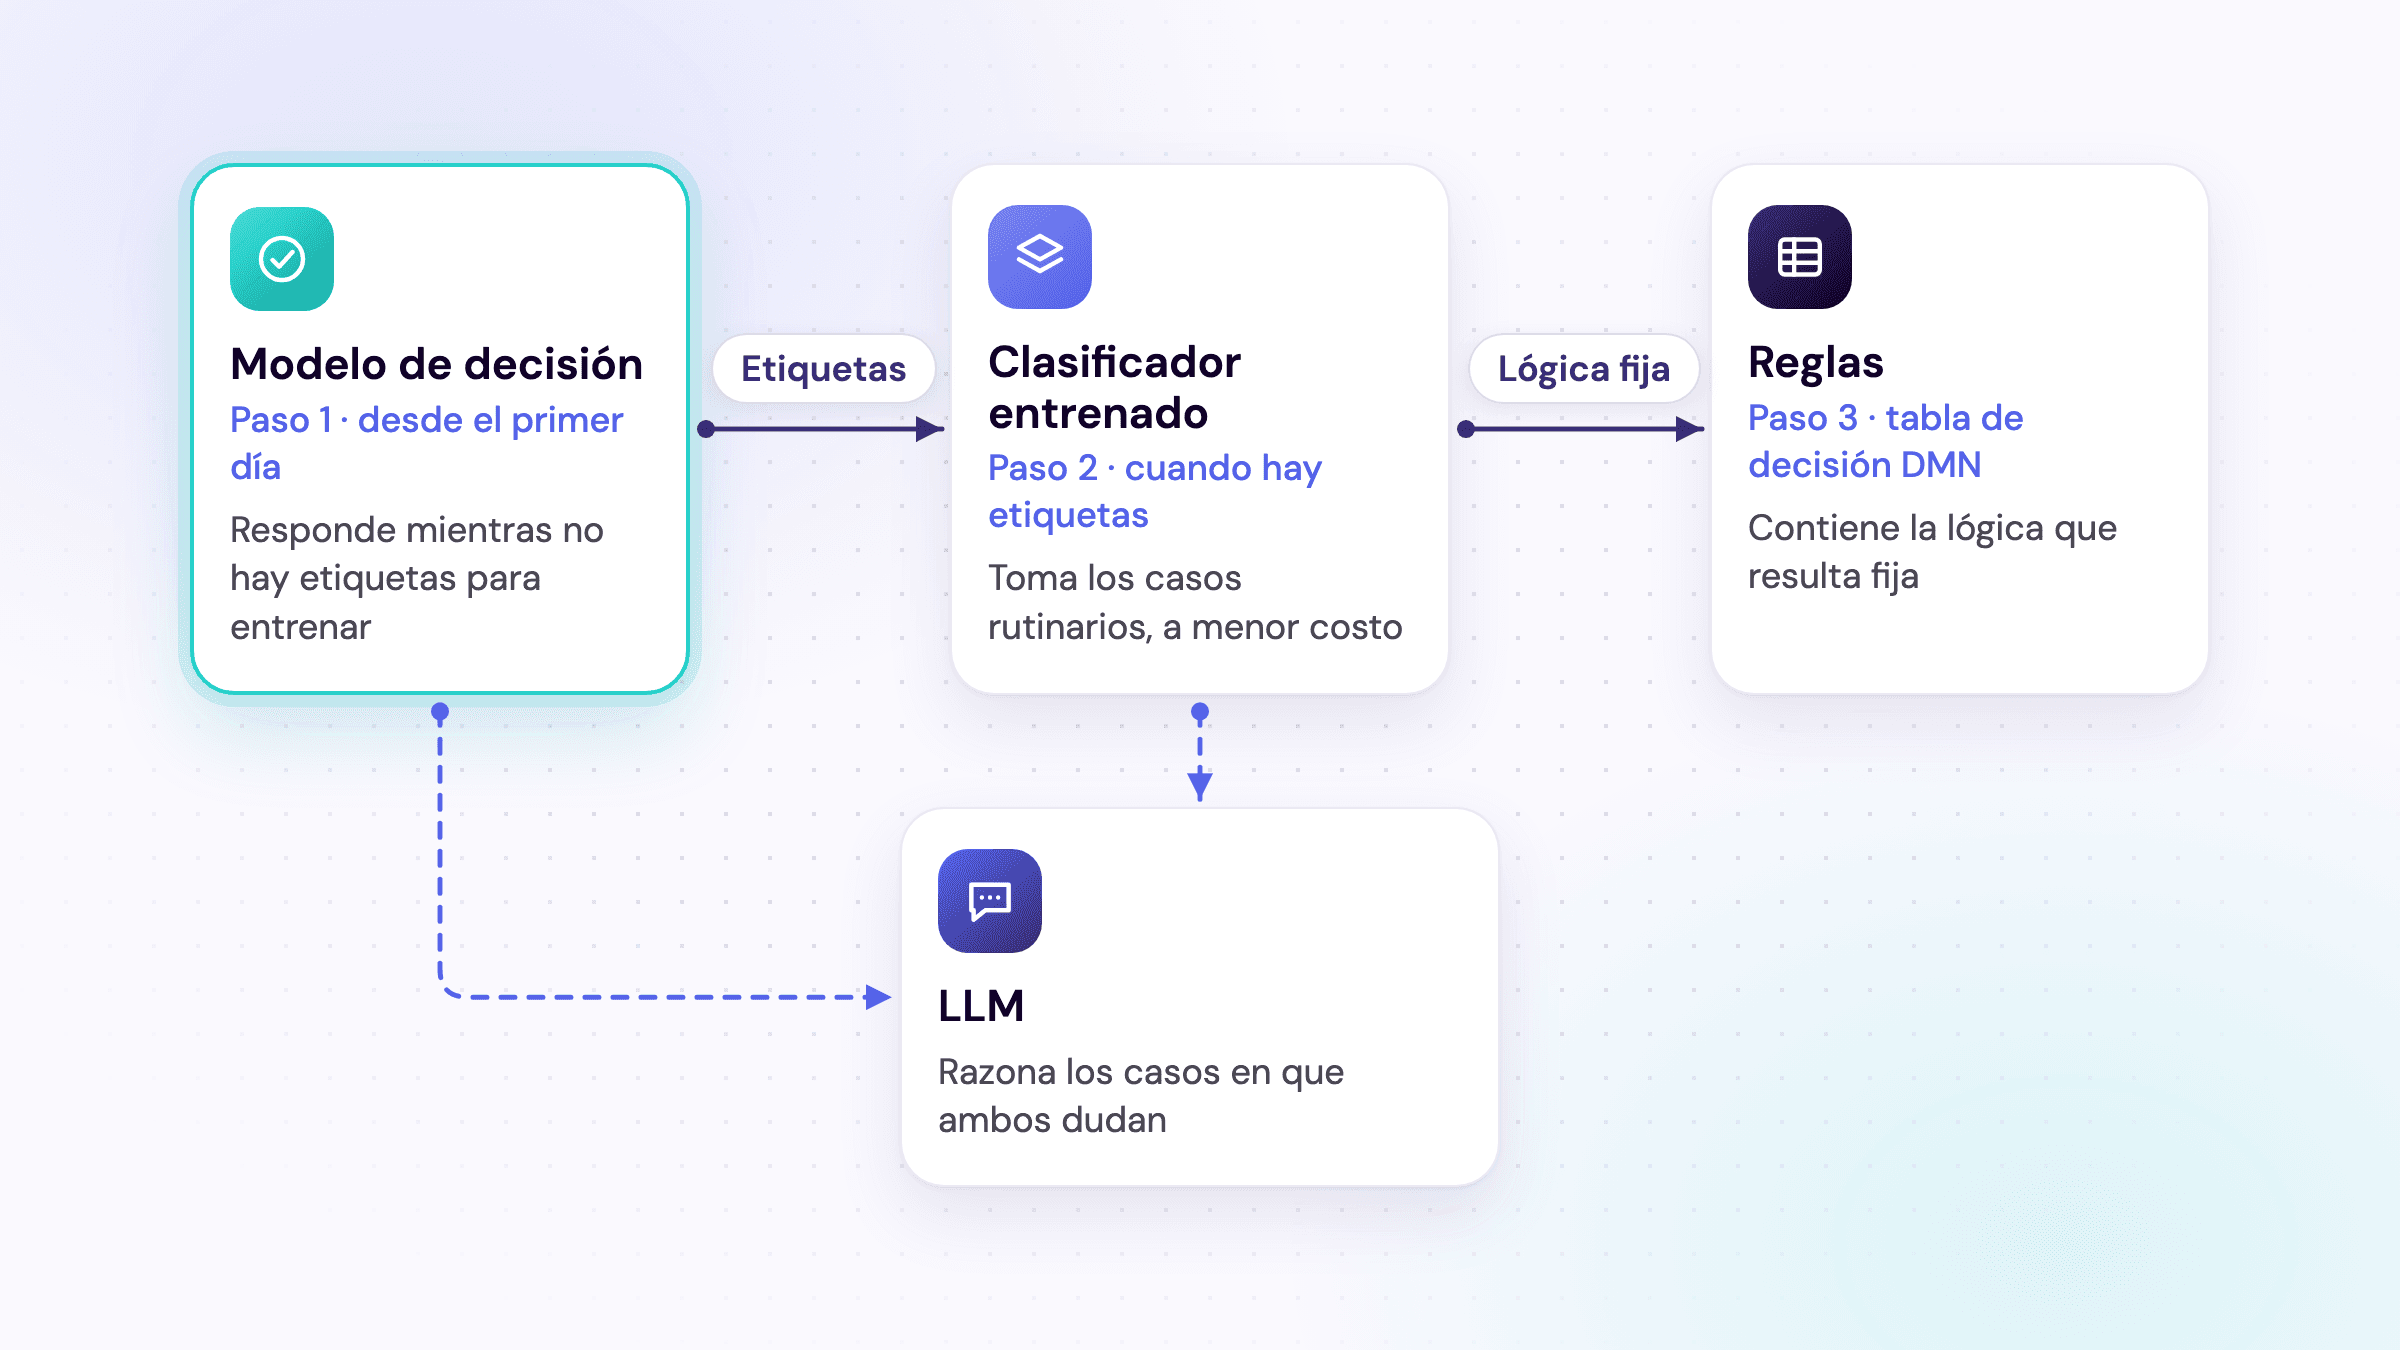
Estos enfoques funcionan mejor como etapas del ciclo de vida de una decisión que como alternativas que compiten entre sí. Una decisión nueva empieza con un modelo de decisión, porque todavía no hay etiquetas con las que entrenar. Cada respuesta queda registrada, y las que las personas confirman o corrigen se convierten en etiquetas.
Cuando la decisión se estabiliza, sus casos rutinarios pasan a un clasificador entrenado, que es menos costoso. Un LLM se encarga de los casos en los que tanto el modelo de decisión como el clasificador tienen dudas, y las reglas asumen la lógica que ha demostrado ser fija.
Las decisiones que deben explicarse regla por regla, como las de crédito o elegibilidad, siguen en manos de una persona o de una tabla de decisión DMN.
Cómo verifica un modelo de decisión las acciones de un agente de IA antes de ejecutarlas
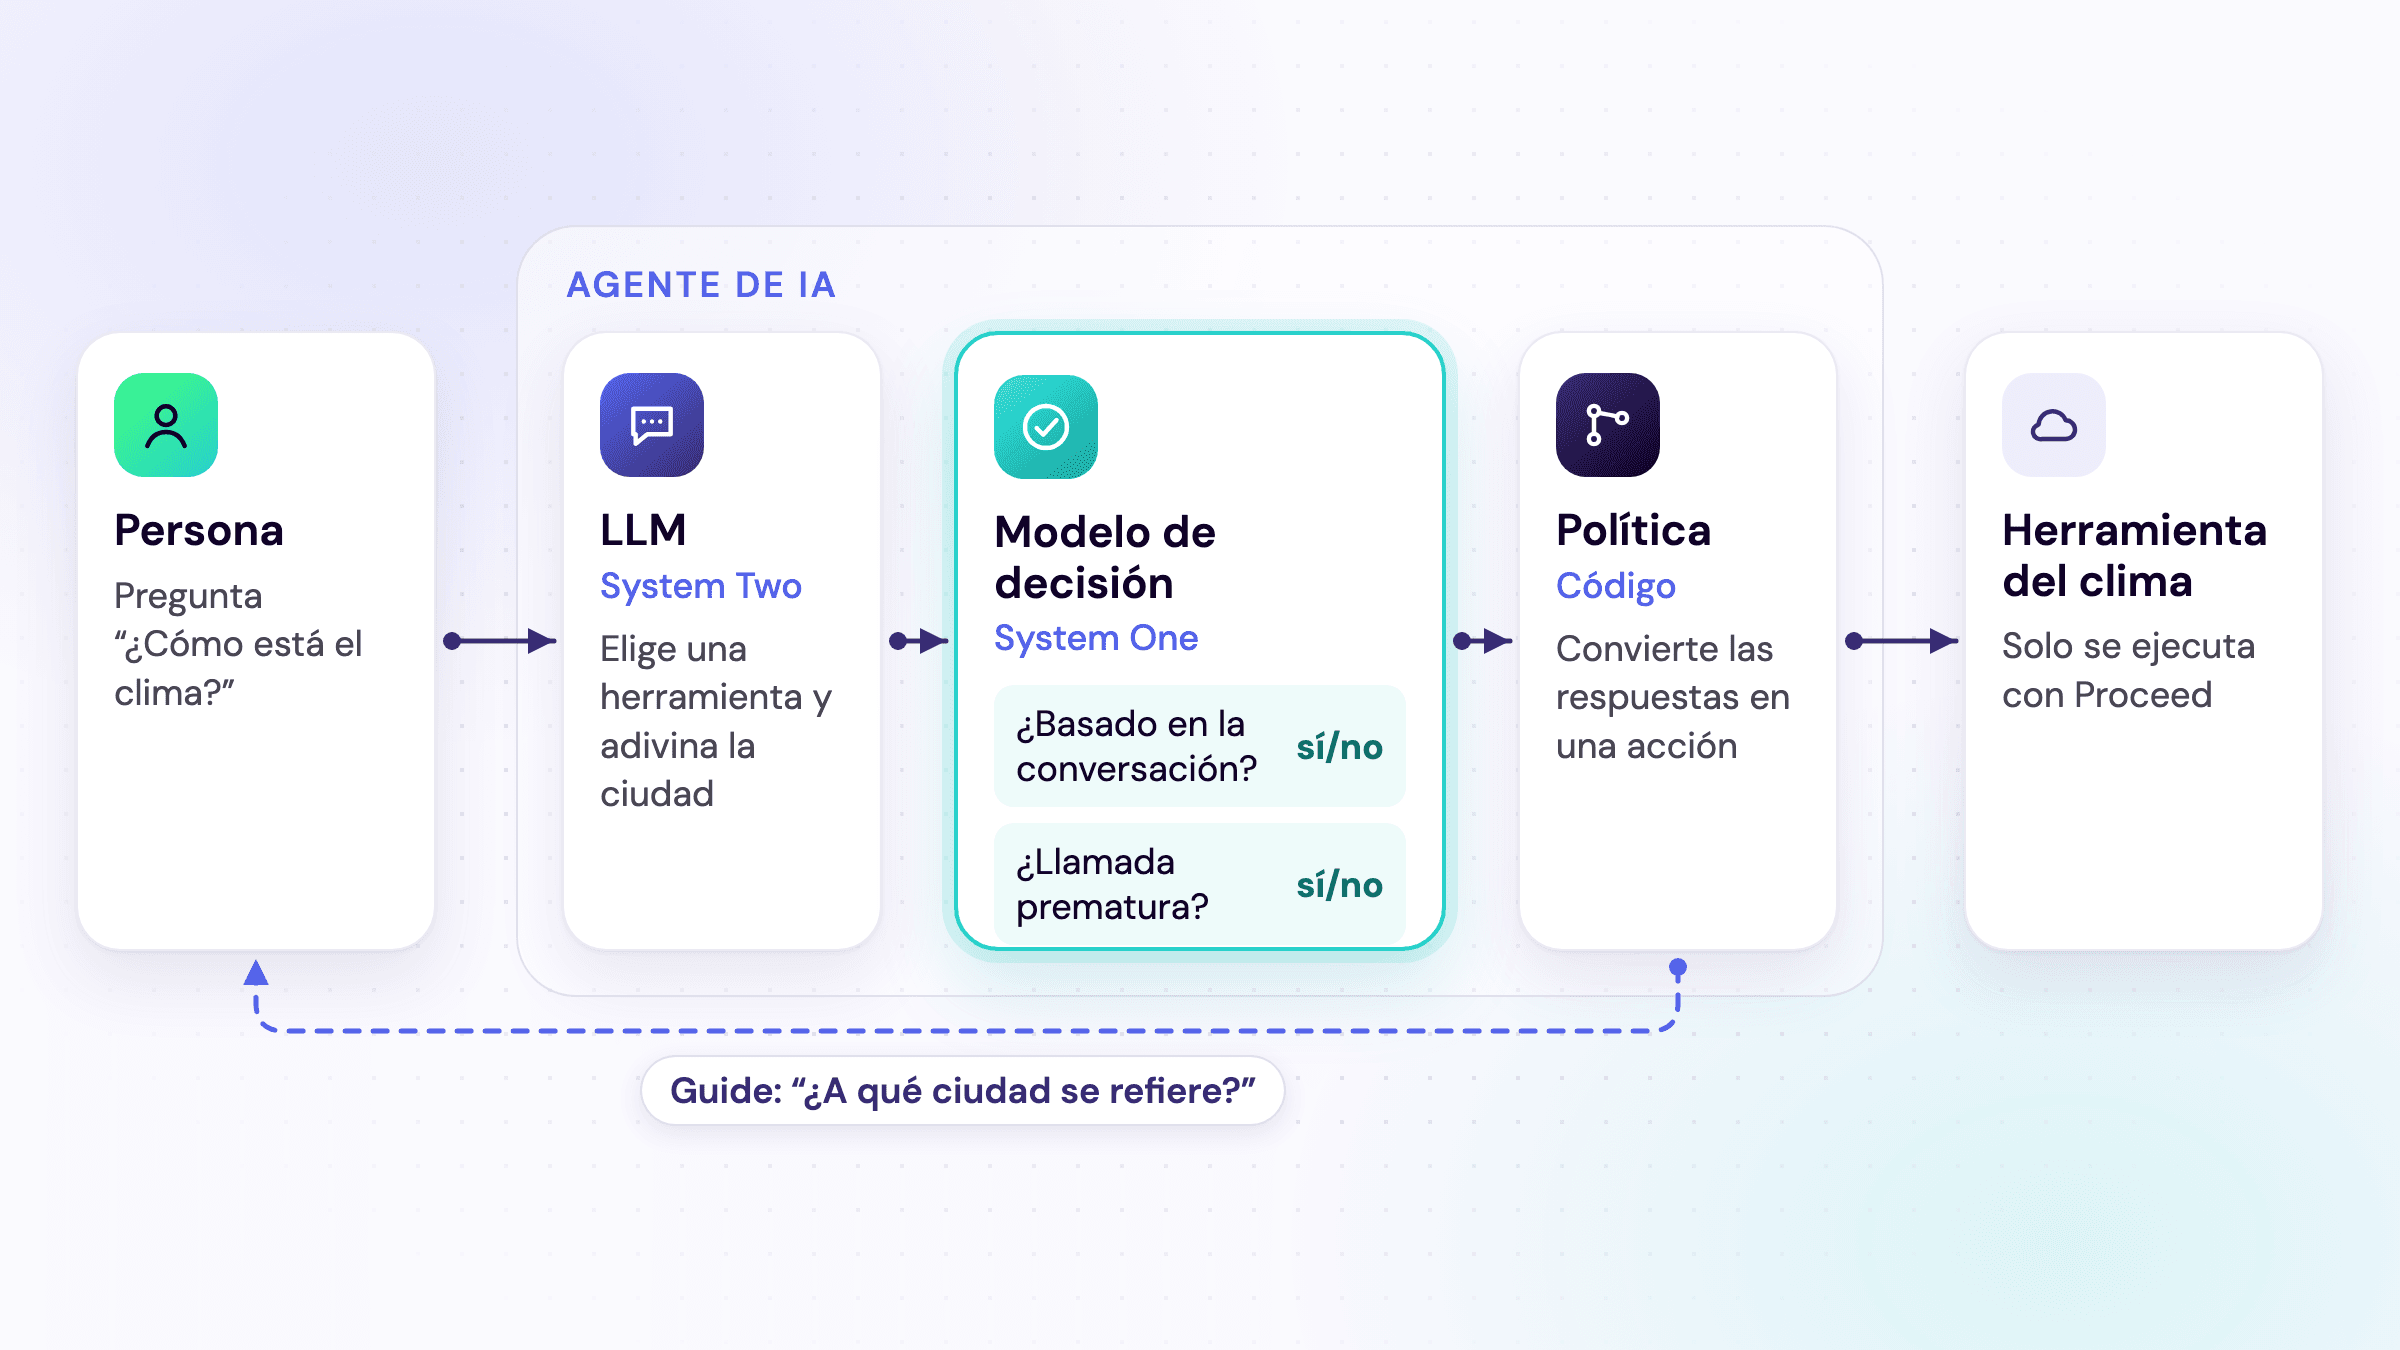
Dentro de un agente de IA, un modelo de decisión puede verificar cada acción antes de que se ejecute. Siguiendo la idea de Kahneman, el LLM cumple el papel de System Two, su Sistema 2: interpreta el objetivo, planifica y redacta. El modelo de decisión cumple el papel de System One y responde las preguntas acotadas y repetitivas.
AWS Strands Labs ilustra el patrón con un ejemplo sencillo. Antes de que un agente llame a una herramienta del clima con una ciudad que no aparece en la conversación, Strands Decider 2B verifica si los argumentos de la llamada se basan en la conversación. Así, el agente le pide a quien lo usa la información que falta, en lugar de adivinarla.
Cómo usar un modelo de decisión de IA
Esta sección muestra cómo ejecutar un modelo de decisión como servidor, enviarle preguntas y actuar según sus respuestas. El ejemplo usa Strands Decider 2B, de AWS, porque está disponible para descarga pública, mientras que Jev está en early access. Los equipos instalan el modelo y lo ejecutan como servidor local:
pip install strands-decider strands-agents
strands-decider serve StrandsAgents/strands-decider-2B-hobson-v21 --port 8000
Las preguntas se envían al servidor por HTTP. Cada pregunta especifica un tipo (noul, choice o score) e instrucciones; las preguntas de tipo choice y score también enumeran sus opciones, en un campo llamado criteria. El formato de solicitud sigue la API pública de Jev, que Kev y Clef también aceptan, aunque AWS no ha verificado la compatibilidad con la API de Jev. AWS documenta el servidor solo para experimentos locales: no tiene autenticación, y AWS todavía no ofrece una versión alojada.
En un agente construido con el Strands Agents SDK de AWS, un handler puede revisar cada llamada a una herramienta (tool call) antes de que se ejecute y devolver una acción como Proceed, Guide, Deny o Confirm. Confirm pausa la llamada hasta que una persona la apruebe. A modo de ilustración, este es un control de activación para el onboarding:
from strands import Agent
from strands.interventions import Confirm, Guide, InterventionHandler, Proceed

class ActivationGate(InterventionHandler):
    name = "activation-gate"

    def before_tool_call(self, event, **kwargs):
        if event.tool_use["name"] != "activate_account":
            return Proceed()
        answers = ask_decider(event)  # POST /v1/systemone: dos preguntas de sí/no
        verified = answers["documents_verified"]["noul"]
        outside_scope = answers["outside_scope"]["noul"]
        if verified >= 0.9 and outside_scope < 0.5:  # umbrales ilustrativos
            return Proceed()
        if verified >= 0.5:
            return Confirm(prompt="¿Aprobar la activación de esta cuenta?")
        return Guide(feedback="Pida primero a la persona solicitante los documentos que faltan.")

agent = Agent(tools=[activate_account], interventions=[ActivationGate()])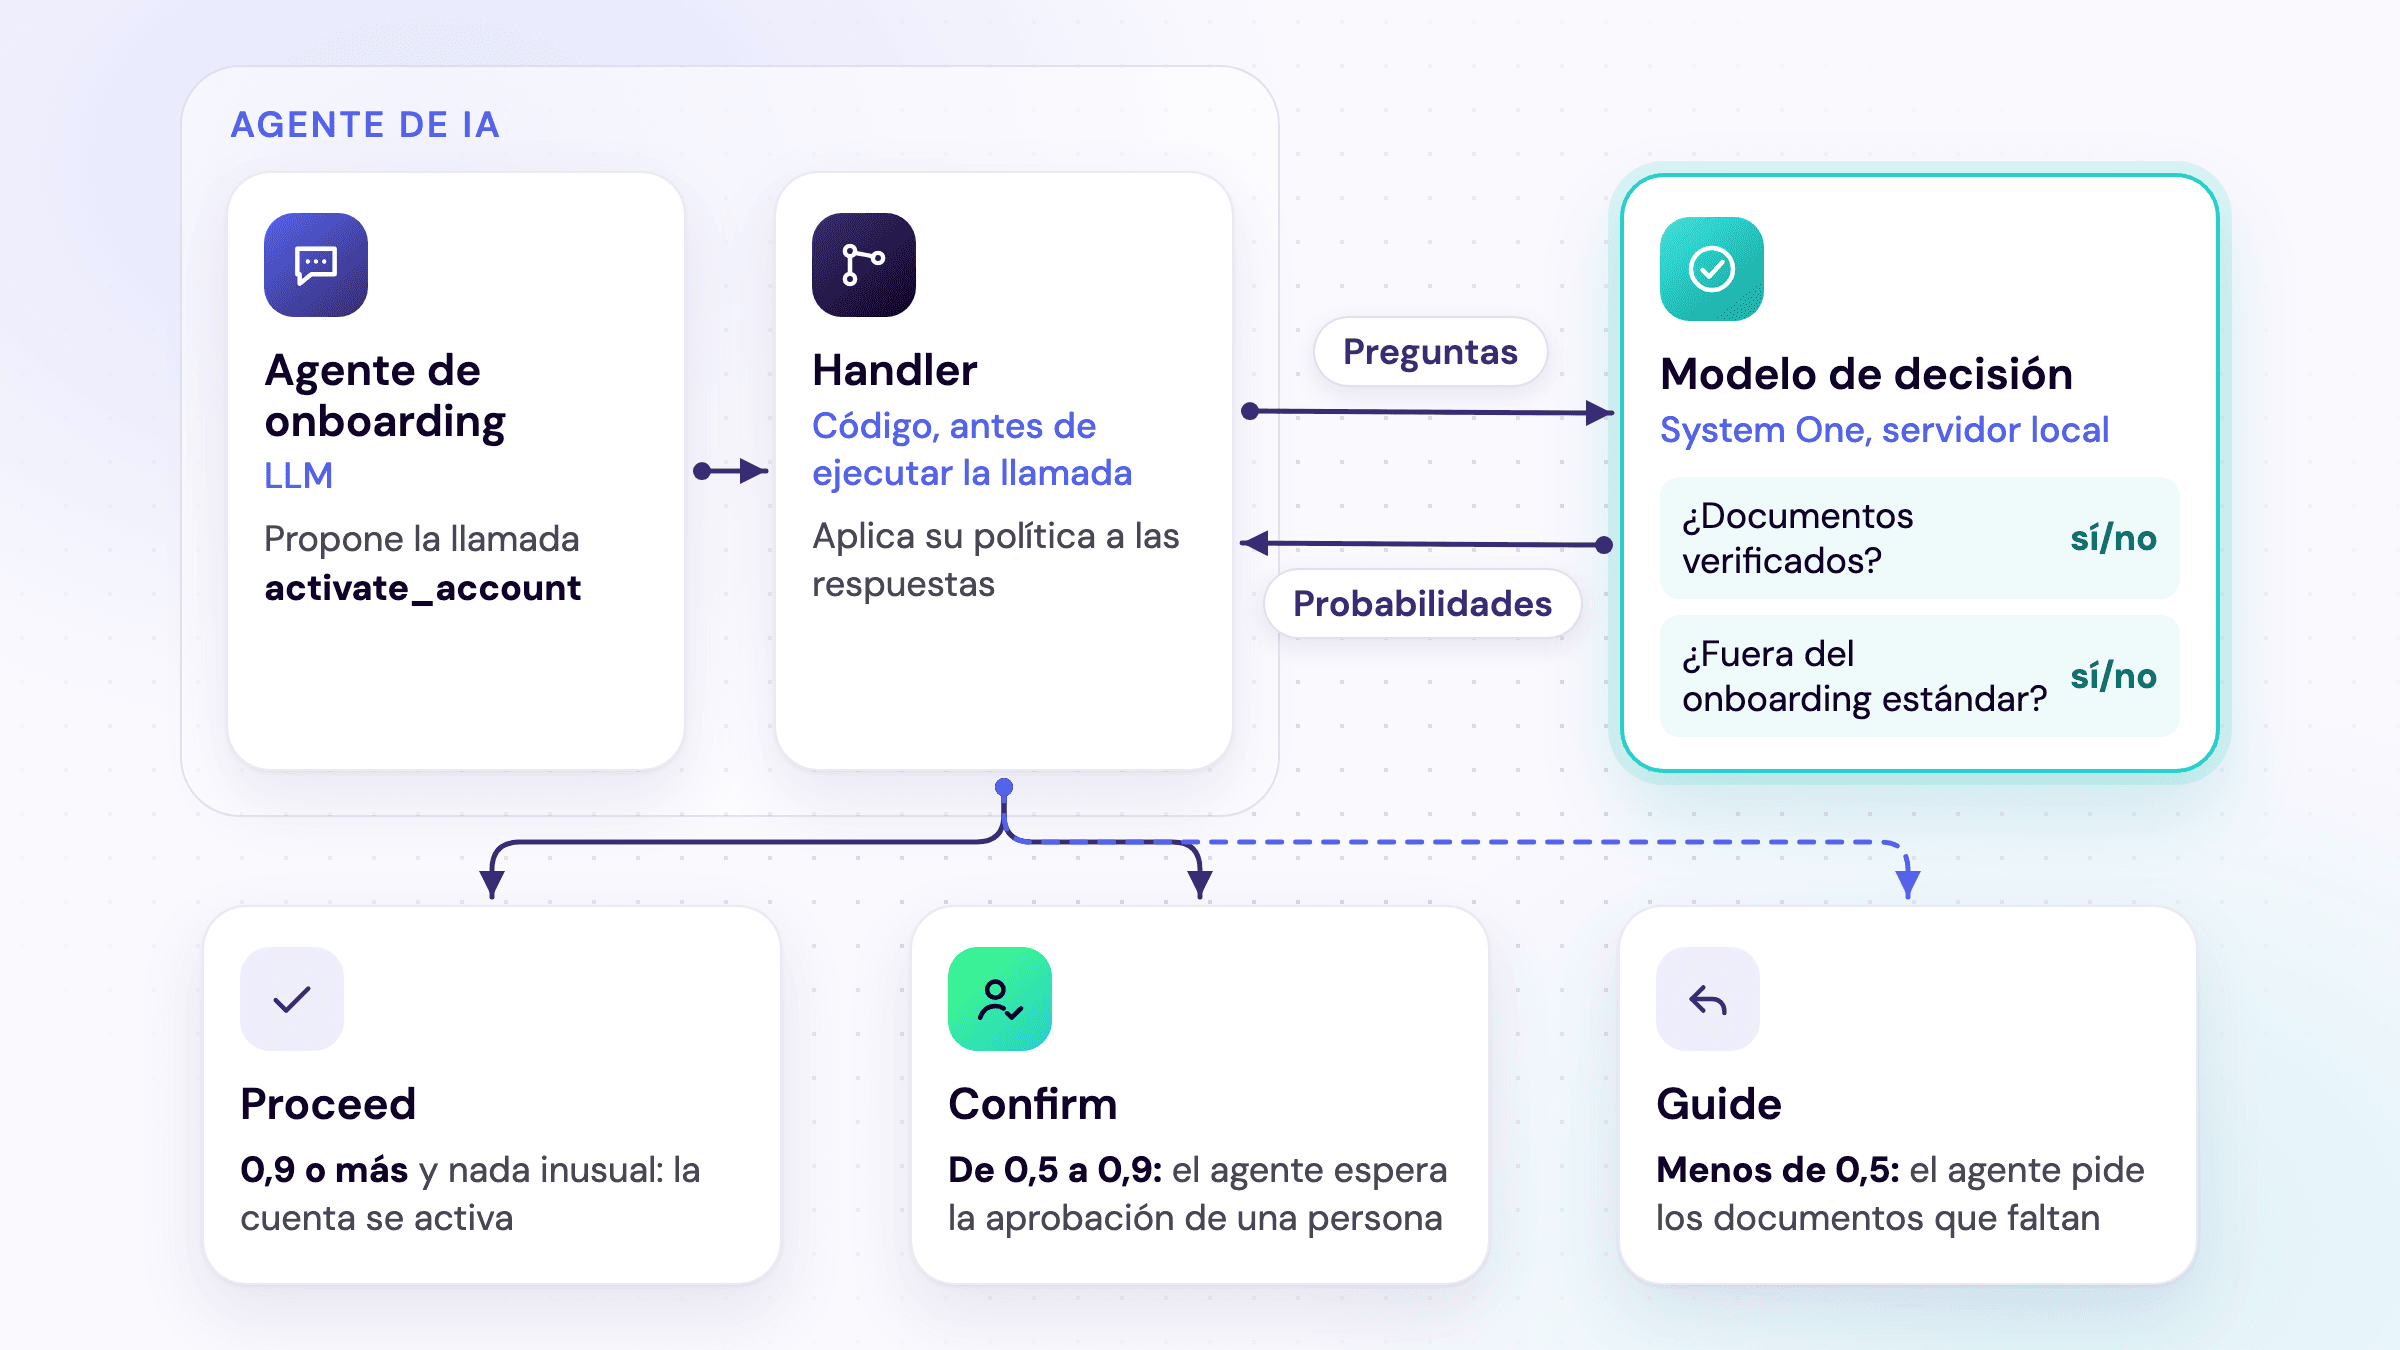
ask_decider representa un cliente HTTP corto; el ejemplo completo de AWS incluye uno en su repositorio. El LLM del propio agente se ejecuta en Amazon Bedrock, de AWS, lo que requiere credenciales de AWS con acceso a Bedrock. Los umbrales son ilustrativos: la documentación de AWS toma prestados los umbrales de ejemplo de Jev (actuar desde 0,9 y pedir confirmación desde 0,5) y recomienda que cada equipo mida los suyos. Al cambiar de modelo, vuelva a revisar los umbrales.
Sea cual sea el modelo que adopte una organización, la probabilidad permite decidir de antemano en qué respuestas puede basarse el software para actuar sin revisión humana:
Defina los umbrales con sus propios datos y fije la versión del modelo. Establézcalos a partir de ejemplos etiquetados y del costo de los errores. La calibración varía según la tarea, y una versión nueva cambia las probabilidades.
Acote las preguntas y el estado. Una pregunta de tipo choice admite como máximo 255 opciones; si necesita más, como los tags de una gran taxonomía de contenidos, pregunte nivel por nivel. Añada una opción "ninguna de las anteriores", haga que los nombres de las opciones coincidan con sus descripciones y resuelva en el código los cálculos de fechas y montos. TypeSafe incluye el conteo, las fechas y el contenido no relacionado entre las debilidades conocidas de Jev.
Registre cada respuesta. El registro alimenta el process mining, que muestra si los umbrales son demasiado estrictos o si quienes revisan anulan con frecuencia la respuesta del modelo. Las respuestas que las personas confirman o corrigen se convierten en las etiquetas que más adelante permiten trasladar los casos rutinarios a un clasificador entrenado menos costoso.
Preguntas frecuentes
¿Qué tan rápidos son los modelos de decisión de IA y cuánto cuestan?
TypeSafe publica para Jev un precio de USD 0,042 por millón de tokens de entrada, sin costo por la salida, y un tiempo de 70 a 500 ms por llamada, medido desde la costa oeste de Estados Unidos. En pruebas independientes, Jev respondió con una mediana de 148 ms y un costo de USD 0,11 por cada 1.000 solicitudes. Un LLM de propósito general, medido en batches en una GPU A100, registró 3.609 ms y USD 1,18. Ejecutado en local, Strands Decider 2B, de AWS, responde en unos 115 ms en una GPU RTX 3090, según AWS. En un sistema completo, Kai Waehner espera un ahorro de costos de alrededor de un orden de magnitud.
¿Los modelos de decisión de IA son simplemente clasificadores?
No exactamente. Un modelo de decisión recibe sus opciones con cada solicitud, en lugar de aprenderlas de etiquetas. Cuando ya hay historial etiquetado, un pequeño clasificador entrenado puede superar a un modelo de decisión en clasificación de intenciones.
¿Los modelos de decisión reemplazan a los LLMs o a los agentes de IA?
No. Se encargan de las evaluaciones acotadas y repetitivas dentro de un agente o de un workflow, y le dejan al LLM el razonamiento, la planificación y la redacción.
¿Por qué no usar el modo JSON de un LLM?
Porque, para actuar según una respuesta, se necesita un nivel de confianza. El modo JSON y otros modos de salida estructurada (structured outputs) restringen lo que un LLM puede escribir, pero el LLM sigue produciendo texto. Un modelo de decisión devuelve una probabilidad por opción, diseñada para estar calibrada en el conjunto de las respuestas. Un LLM solo indica una probabilidad en su respuesta cuando se le pide, y su texto tiene que coincidir con lo que espera el software. En pruebas independientes, cuando se le pidió a un LLM responder en JSON, 160 de 600 respuestas no se ajustaron al formato esperado. En ambos casos, una respuesta elegida entre las opciones definidas aún puede ser incorrecta, y las pruebas con los datos de la propia organización muestran con qué frecuencia ocurre.
¿Los modelos de decisión funcionan en español?
Requieren una validación previa. Las cifras que cita esta guía provienen de datos en inglés. El checkpoint multilingüe de Laya cubre más de 100 idiomas, según su model card. Sin embargo, el equipo que desarrolló Laya encontró que el checkpoint en inglés podía mantener una confianza alta aun cuando fallaba con algunas entradas que no estaban en inglés. Para otros idiomas, Jared Palmer, quien mantiene Kev, recomienda un fine-tuning breve con las etiquetas de la propia organización.
¿Puede un modelo de decisión explicar su respuesta?
No. Devuelve un valor por pregunta y ningún texto, y su lógica es aprendida, así que no hay ninguna regla que citar.
¿Qué diferencia hay entre un modelo de decisión de IA y DMN?
Decision Model and Notation (DMN) expresa la lógica de decisión en tablas que una persona puede leer regla por regla. Un modelo de decisión, en cambio, aprende su criterio y devuelve una probabilidad.
Cómo los modelos de decisión llevan la automatización agéntica a los procesos de negocio
La pregunta para cada organización es dónde corresponde hoy cada decisión: en reglas, en un clasificador entrenado, en un modelo de decisión o en un LLM. En un proceso de negocio, un modelo de decisión de IA y una tabla DMN pueden compartir un mismo paso de decisión: el modelo interpreta la entrada no estructurada y la tabla determina qué puede desencadenar cada respuesta. Así es como la automatización tradicional de procesos se convierte en un sistema agéntico, decisión por decisión. Aplyca llama a esto gestión agéntica de procesos de negocio, o BPM agéntico: IA integrada en los procesos de negocio, dentro de los límites que define la organización y con aprobación humana en las decisiones de mayor impacto. El proceso pregunta, un modelo de decisión responde y, según la confianza de la respuesta, el motor de procesos actúa en consecuencia, pasa el caso a un LLM o lo enruta a una persona. Al precio de lista de Jev, una respuesta cuesta alrededor de una centésima de centavo de dólar, lo que hace asequible incluir una en cada paso de un proceso. Aplyca ayuda a las organizaciones a hacer esta transición y a llevar la orquestación de procesos más allá de las reglas fijas.